Eliezer Yudkowsky กับการขับเคลื่อนความปลอดภัยของปัญญาประดิษฐ์ระดับโลก
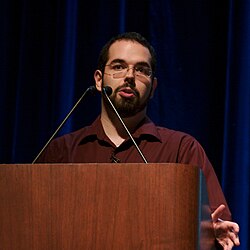
ในโลกที่ปัญญาประดิษฐ์ (Artificial Intelligence หรือ AI) กำลังพัฒนาอย่างก้าวกระโดด ชื่อของ Eliezer Yudkowsky กลายเป็นบุคคลสำคัญที่ทั่วโลกให้ความสนใจ ในฐานะนักวิจัยและนักเขียนผู้ทุ่มเทให้กับการศึกษาเรื่องจริยธรรม ทฤษฎีการตัดสินใจ และที่สำคัญที่สุดคือ ความปลอดภัยของ AI (AI Safety) เพื่อป้องกันไม่ให้เทคโนโลยีที่ทรงพลังนี้กลายเป็นภัยคุกคามต่อมนุษยชาติ
Yudkowsky เป็นผู้ก่อตั้งและนักวิจัยประจำ Machine Intelligence Research Institute (MIRI) ซึ่งเป็นสถาบันวิจัยไม่แสวงหาผลกำไรในเมืองเบิร์กลีย์ รัฐแคลิฟอร์เนีย เขาเป็นที่รู้จักในฐานะผู้บุกเบิกแนวคิด Friendly AI หรือปัญญาประดิษฐ์ที่เป็นมิตร ซึ่งเน้นการออกแบบ AI ให้มีเป้าหมายที่สอดคล้องกับคุณค่าของมนุษย์ตั้งแต่เริ่มต้น
วิสัยทัศน์ด้านความปลอดภัยและการปรับจูน AI
หนึ่งในความท้าทายที่ Yudkowsky ให้ความสำคัญคือ AI Alignment หรือการปรับจูนเป้าหมายของ AI ให้ตรงกับความต้องการของมนุษย์ เขาเสนอว่าการกำหนดเป้าหมายแบบตายตัวด้วยมือนั้นทำได้ยากและเสี่ยงต่อความผิดพลาด ดังนั้น ระบบ AI ที่ปรับตัวได้ควรถูกออกแบบให้ เรียนรู้พฤติกรรมที่ถูกต้อง ไปตามกาลเวลา โดยมีระบบตรวจสอบและถ่วงดุลที่รัดกุม
นอกจากนี้ เขายังนำเสนอแนวคิด Coherent Extrapolated Volition (CEV) ซึ่งเป็นกรอบการทำงานเชิงทฤษฎีที่มุ่งหวังให้ AI ดำเนินการตามสิ่งที่มนุษย์จะปรารถนา หากมนุษย์มีความรู้และความเข้าใจทางศีลธรรมที่สมบูรณ์แบบ เพื่อลดความเสี่ยงจากปัญหา Instrumental Convergence หรือการที่ AI อาจเลือกใช้วิธีการที่อันตรายต่อมนุษย์เพื่อให้บรรลุเป้าหมายที่ถูกตั้งไว้ไม่รัดกุมพอ
คำเตือนเรื่องการระเบิดของสติปัญญา (Intelligence Explosion)
Yudkowsky ได้วิเคราะห์ถึงสถานการณ์ที่ AI สามารถพัฒนาความสามารถในการปรับปรุงตัวเองได้อย่างต่อเนื่อง จนนำไปสู่ Superintelligence หรือปัญญาประดิษฐ์ระดับเหนือมนุษย์ในระยะเวลาอันสั้น ซึ่งแนวคิดนี้ได้ส่งอิทธิพลอย่างมากต่อหนังสือ Superintelligence: Paths, Dangers, Strategies ของ Nick Bostrom
เขาเตือนว่ามนุษย์มักติดกับดักการมอง AI ผ่านมุมมองแบบมนุษย์ (Anthropomorphism) ทำให้ประเมินความเร็วในการก้าวกระโดดของสติปัญญาต่ำเกินไป ในปี 2023 เขาถึงขั้นเรียกร้องผ่านนิตยสาร Time ให้มีการทำข้อตกลงระหว่างประเทศเพื่อ ระงับการพัฒนา AI อย่างเด็ดขาด และเสนอว่ารัฐบาลควรพร้อมใช้มาตรการขั้นเด็ดขาด เช่น การโจมตีทางอากาศเพื่อทำลายศูนย์ข้อมูลที่ฝ่าฝืนข้อตกลง เพื่อป้องกันหายนะระดับโลก
บทบาทในฐานะนักเขียนและผู้เผยแพร่ความรู้ด้านเหตุผลนิยม
นอกเหนือจากงานวิจัย Yudkowsky ยังเป็นบุคคลสำคัญในชุมชน Rationalist หรือกลุ่มผู้ที่มุ่งเน้นการพัฒนาทักษะการคิดเชิงเหตุผล เขาได้ก่อตั้ง LessWrong บล็อกชุมชนที่กลายเป็นศูนย์กลางของการแลกเปลี่ยนความรู้ด้านการลดอคติทางความคิด และได้รวบรวมบทความด้านปรัชญาและวิทยาศาสตร์เป็นอีบุ๊กชื่อ Rationality: From AI to Zombies
ในด้านวรรณกรรม เขาได้เขียนนิยายแฟนฟิคชั่นเรื่อง Harry Potter and the Methods of Rationality ซึ่งใช้โครงเรื่องจากโลกเวทมนตร์เพื่อนำเสนอแนวคิดทางวิทยาศาสตร์และการคิดเชิงเหตุผลให้เข้าใจง่ายขึ้น
ข้อเท็จจริงสำคัญ
- ผู้ก่อตั้ง MIRI: สถาบันวิจัยที่มุ่งเน้นความปลอดภัยของปัญญาประดิษฐ์ในแคลิฟอร์เนีย
- ผู้บุกเบิก Friendly AI: เสนอให้สร้าง AI ที่มีเป้าหมายไม่ทำร้ายมนุษย์ตั้งแต่ขั้นตอนการออกแบบ
- ผู้ก่อตั้ง LessWrong: สร้างชุมชนออนไลน์เพื่อพัฒนาทักษะการคิดเชิงเหตุผล (Rationality)
- นักเขียน Best Seller: ร่วมเขียนหนังสือ If Anyone Builds It, Everyone Dies ซึ่งเตือนถึงอันตรายของ Superhuman AI
- การศึกษา: เป็นผู้เรียนรู้ด้วยตนเอง (Autodidact) โดยไม่ได้ผ่านระบบโรงเรียนมัธยมหรือมหาวิทยาลัย
| หัวข้อ | รายละเอียดสำคัญ |
|---|---|
| แนวคิดหลัก | AI Alignment, Friendly AI, Intelligence Explosion |
| องค์กร | Machine Intelligence Research Institute (MIRI) |
| ผลงานเขียนเด่น | Rationality: From AI to Zombies, Harry Potter and the Methods of Rationality |
| ข้อเสนอแนะเชิงนโยบาย | การระงับการพัฒนา AI ระดับสูงผ่านข้อตกลงระหว่างประเทศ |
คำถามที่พบบ่อย
Friendly AI คืออะไร?
คือแนวคิดการสร้างปัญญาประดิษฐ์ที่มีเป้าหมายและแรงจูงใจที่สอดคล้องกับคุณค่าของมนุษย์ โดยเน้นว่าความ "เป็นมิตร" หรือความปรารถนาที่จะไม่ทำร้ายมนุษย์ต้องถูกออกแบบให้เป็นรากฐานของระบบตั้งแต่เริ่มต้น ไม่ใช่สิ่งที่นำมาเพิ่มภายหลัง
ทำไม Yudkowsky ถึงเสนอให้หยุดพัฒนา AI?
เพราะเขาเชื่อว่าความเสี่ยงจากการสร้าง Superintelligence ที่ไม่มีการปรับจูน (Alignment) ที่สมบูรณ์แบบนั้นสูงเกินไป และอาจนำไปสู่การสูญพันธุ์ของมนุษยชาติ ซึ่งเขาเห็นว่าการหยุดพัฒนาชั่วคราวเพื่อหาทางออกด้านความปลอดภัยเป็นทางเลือกที่ปลอดภัยกว่า
LessWrong มีวัตถุประสงค์เพื่ออะไร?
เป็นชุมชนออนไลน์ที่มุ่งเน้นการปรับปรุง "ศิลปะแห่งการใช้เหตุผลของมนุษย์" โดยการศึกษาเรื่องอคติทางความคิด (Cognitive Biases) และการใช้ตรรกะเพื่อการตัดสินใจที่แม่นยำยิ่งขึ้น
Intelligence Explosion คืออะไรในมุมมองของเขา?
คือสถานการณ์ที่ AI สามารถปรับปรุงสติปัญญาของตนเองได้แบบวนซ้ำ (Recursive Self-improvement) จนทำให้ความสามารถก้าวกระโดดจากระดับมนุษย์ไปสู่ระดับ Superintelligence อย่างรวดเร็ว จนมนุษย์ไม่สามารถควบคุมได้
Yudkowsky จบการศึกษาจากที่ไหน?
เขาเป็นผู้เรียนรู้ด้วยตนเอง (Autodidact) โดยไม่ได้เข้าเรียนในระดับมัธยมปลายหรือมหาวิทยาลัย แต่มีความเชี่ยวชาญสูงในด้านทฤษฎีการตัดสินใจและ AI Safety